Der KI-Flaschenhals wandert ins Glasgewebe und 3D-DRAM
Nittobo kontrolliert rund 90% des globalen T-Glas-Angebots. Dieses spezialisierte Glasfasergewebe steckt in jedem fortgeschrittenen KI-Chip-Gehäuse. Der Engpass verändert die Lieferketten, berichtet Tom's Hardware.
 Katrin HoffmannKI, Modelle und Technik
Nittobo verdreifacht die Kapazität in seinem Werk in Fukushima, Japan. Die neue Ware erreicht den Markt erst Mitte 2027, wie Tom's Hardware am 9. März berichtete. Die Materialpreise sind um 20 bis 30% gestiegen. Die Lieferzeiten für Kupferlaminat haben sich von den üblichen 8 bis 10 Wochen auf über 20 Wochen verlängert.
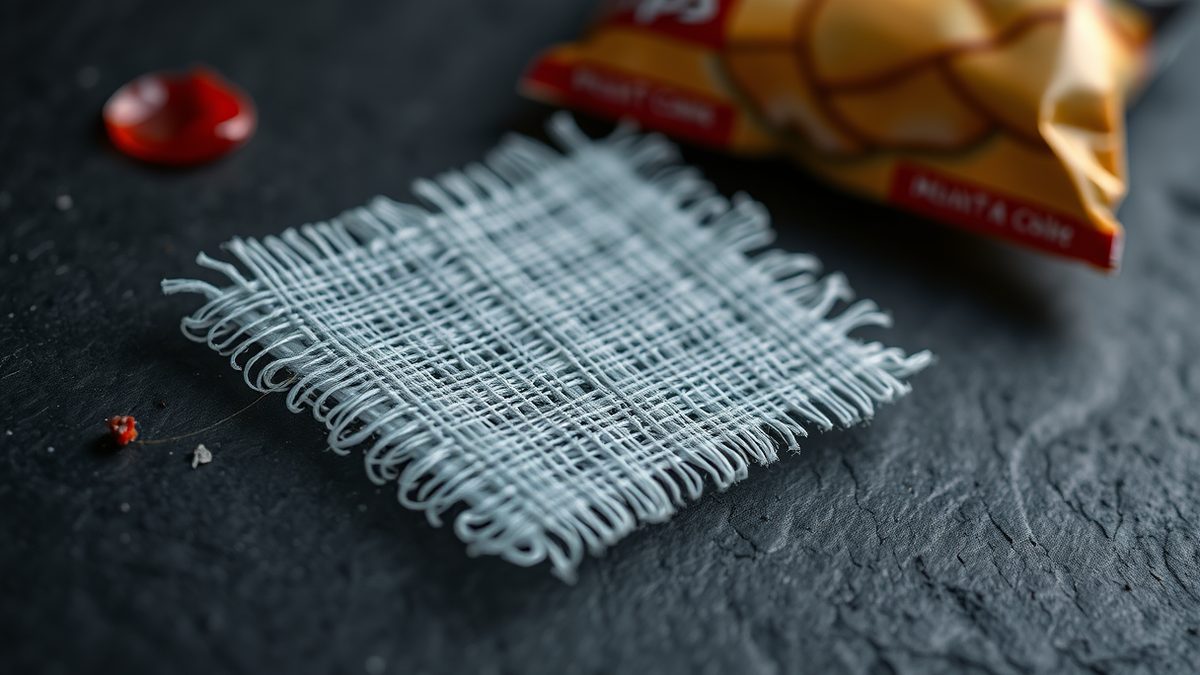
T-Glas ist ein Glasgewebe mit niedrigem CTE. Es wird im organischen Kern von IC-Substraten verwendet, der die Verbindung zwischen Chip und Leiterplatte herstellt. Das Material hält große, stark erhitzte Chip-Gehäuse dimensionsstabil. Das gewinnt an Bedeutung, da KI-Prozessoren größer werden und heißer laufen. Das günstigere E-Glas kommt hauptsächlich in niedrigeren Chips wie Mikrocontrollern und älteren Mobilprozessoren zum Einsatz. Für massives 2.5D- und 3D-Packaging ist T-Glas die bevorzugte Option. Diese Kombination aus Eigenschaften und begrenzter Ersetzbarkeit macht ein Nischenmaterial zum Engpass in der Lieferkette. Die Knappheit ist akut, weil Hyperscaler immer größere Chip-Gehäuse bestellen, die pro Einheit mehr T-Glas erfordern.
Laut Nvidia-Daten, die Tom's Hardware zitierte, sind die Interposer-Größen von 814 mm² bei der Hopper-Architektur auf 1.700 mm² bei Blackwell gewachsen. Das entspricht einer Steigerung um 109%. Rubin und Feynman skalieren weiter. „Da das T-Glas-Angebot jetzt noch knapper ist, nennen die Lieferanten keine Lieferzeiten mehr“, sagte Bill Ho, Analyst bei Yuanta, dem Medium.
Eine Ersetzung ist nicht einfach. Bilal Hachemi, Analyst bei Yole Group, der die Lieferkette für IC-Substrate beobachtet, erklärte, T-Glas habe „spezifische Dielektrikums- und CTE-Werte, die besser für KI-Chips funktionieren, besonders für den organischen Kern“. Er fügte hinzu, dass die Substratbranche historisch mit dünnen Margen gearbeitet habe. Schon moderate Nachfrageanstiege können daher Engpässe auslösen.
Nittobos Antwort geht über Fukushima hinaus. Das Unternehmen verdoppelt die Rohfadenkapazität in seinem taiwanesischen Werk und importiert Fäden zurück nach Japan zur Gewebeproduktion. Zudem hat es eine Kooperationsvereinbarung mit Nanya Plastics getroffen, um ein Teil des Webens zu outsourcen. Bis 2027 wird erwartet, dass rund 20% von Nittobos Glasgewebe von Nanya, einem Wettbewerber, gewebt werden. Das zeigt, wie eng der Markt ist. Bank of America schätzt, dass der Bereich für elektronische Materialien von Nittobo den Umsatz von 40.900.000.000 Yen (266.000.000 Dollar) im Jahr 2025 auf 87.700.000.000 Yen bis März 2028 nahezu verdoppeln wird. Die operativen Margen sollen dabei nahe an 48% liegen.
Mittlerweile greifen Beschleuniger-Designer die Speicherwand von einer anderen Seite an. Auf Hot Chips 2026 präsentierte d-Matrix Raptor, einen 3D-DRAM-Beschleuniger für generative Inferenz. Das Gerät stapelt einen TSMC N4-Logikchip auf einen 3D-DRAM-Chip, mit 36 um Face-to-Face-Stacking, berichtet ServeTheHome. Das Unternehmen dimensioniert einen 72-Karten-Scale-up-Rack, um ein Frontier-Modell wie Kimi K3 mit 1M Kontext unterzubringen. Dabei kommen 32GB pro Karte zum Einsatz, mit 4-Bit-Gewichten und einem 8-Bit-KV-Cache.
Das Argument für vertikales Stapeln ist Energie. On-Die-SRAM kostet etwa 50 fJ. 2.5D-HBM4-Systeme liegen bei Berücksichtigung der Chip-Energie im Bereich von 2,5 bis 5 pJ. Vertikales 3D-IO kommt auf etwa 0,3 bis 0,4 pJ. Das ist rund 10-mal niedriger als HBM, da es ein PHY-freier, millimetergroßer Pfad ist und kein zentimetergroßer Interposer-Weg. d-Matrix nennt eine praktische Bandbreitengrenze von etwa 20 TB/s für HBM4-Pakete.
Microsoft geht einen anderen Weg mit Maia 200. Der 3-nm-Chip trägt 140.000.000.000 Transistoren, 6 HBM3e-Stacks, 7TB/s HBM-Bandbreite, 10.000 TFLOPS FP4-Leistung und eine TDP von 750 Watt, berichtete ServeTheHome von derselben Konferenz. Es gibt kein Scale-out-Netzwerk, nur Scale-up. Die demonstrierte Konfiguration umfasst 128 Racks und 6.000 Chips.
Forschungsbemühungen zeigen weiter in die Zukunft. Stanford, Carnegie Mellon, Penn, MIT und SkyWater Technology bauten den ersten monolithischen 3D-Chip in einer US-Foundry. Der Prototyp übertraf vergleichbare 2D-Chips um etwa den Faktor vier. Simulationen höherer Designs zeigten bis zu zwölffache Verbesserungen bei KI-Workloads, berichtet Stanford Engineering.
Quellen
4- 01Shortages of crucial chip packaging material threatens AI accelerator supply chainsEN
- 02d-Matrix Raptor 3D-DRAM Accelerator for Generative Inference at Hot Chips 2026EN
- 03Microsoft's Maia 200 AI Accelerator at Hot Chips 2026EN
- 04Scientists and U.S. foundry achieve 3D chip breakthrough to accelerate AIEN
Alle Zahlen und Zitate in diesem Text stammen aus den unten genannten Quellen.
Die Materialien wurden vom Redaktionsteam mit Unterstützung von KI erstellt.
Katrin Hoffmann
Kommentare
0- Noch keine Kommentare — seien Sie der Erste.