Inferenza: un motore cinese moltiplica per 6,87 il throughput di DeepSeek V4.1 Flash su GPU PCIe
Su otto schede PCIe senza interconnessione ad alta velocità, il motore Meta-Infer di METASTONE è passato da 1.932 a 13.274 token al secondo. Tutto con il solo software, senza toccare il modello.
 Giulia FerrariIA, modelli e tecnologie
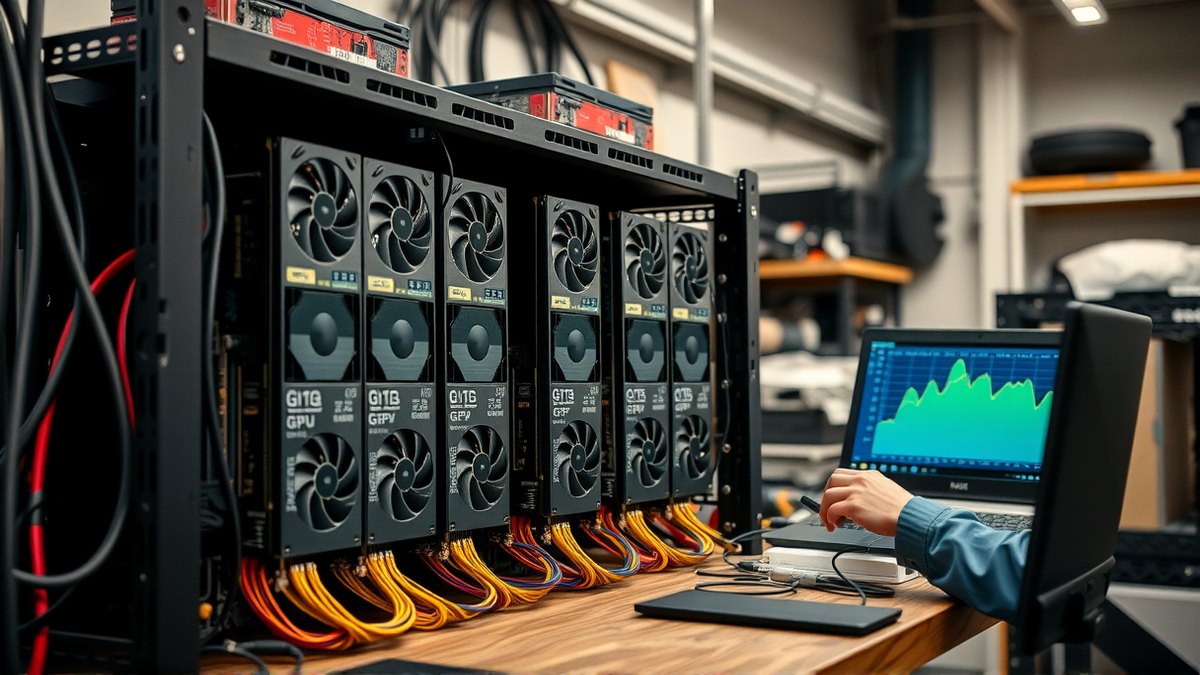
Il dibattito sui chip per l'IA cambia direzione. Non conta più solo chi può comprare l'hardware più potente, ma chi sa sfruttare al meglio quello già disponibile. È la tesi di METASTONE, azienda cinese che con il suo motore di inferenza Meta-Infer dimostra questo approccio, come riferisce 量子位 (QbitAI).
La frattura tra framework e hardware
Molte schede grafiche sanno caricare un modello, scaricare i pesi e avviare un servizio: funzionano. Ma nei test di carico le prestazioni reali restano spesso molto sotto i livelli annunciati. Il modello non ha difetti e l'hardware non è guasto: la perdita nasce dallo scarto tra framework e hardware. Queste schede non hanno interconnessioni ad alta velocità tra loro e non compaiono nelle matrici di validazione ufficiali dei framework aperti. Risultato: gli operatori ricadono silenziosamente su implementazioni generiche poco efficienti, i parametri di comunicazione restano tarati per altre architetture e la configurazione di memoria o parallelismo riprende valori predefiniti pensati per un altro hardware.
Sei virgola otto sette volte più throughput
Meta-Infer affronta il problema con il solo software, senza modificare la struttura del modello né la semantica dei task. L'approccio si divide in quattro parti: completamento dei kernel, ottimizzazione degli operatori e riscrittura della comunicazione, regolazione del parallelismo e della capacità di memoria, infine riuso della cache.
La prima parte corregge metadati e dimensioni di pagina che bloccano l'esecuzione degli operatori ottimizzati nativi, sostituisce kernel vecchi e inadatti e allarga la soglia dei percorsi di comunicazione rapida. Su un ambiente di otto schede PCIe, con la versione community di riferimento per DeepSeek-V4.1-Flash, il throughput in ingresso era di soli 1.932 token al secondo. Dopo questa fase di correzione sale a 5.850 token al secondo.
La seconda parte attacca i colli di bottiglia. Su un'architettura PCIe la banda tra schede è molto inferiore a quella di un'interconnessione dedicata. Applicare le strategie predefinite significa passare il tempo in attese di comunicazione. Il motore fonde gli operatori, sovrappone il calcolo alla comunicazione e riscrive la logica di comunicazione collettiva. Arriva così a 13.274 token al secondo, un fattore di 6,87, con il supporto di contesti molto lunghi.
La metodologia vuole essere generica: su un altro modello il throughput in ingresso passa da 14.546 a 22.584 token al secondo. Già con la sola fase di co-adattamento diversi modelli guadagnano tra il 20% e il 33% di throughput.
Un operatore terzo
METASTONE si presenta come operatore di calcolo end-to-end indipendente, non legato a un fornitore di modelli. L'azienda dichiara di gestire più di 20.000 petaflops di risorse, di utilizzare una decina di centri di calcolo intelligenti e due centri nazionali di supercalcolo, con un impegno di disponibilità superiore al 99,95%. Il suo team rivendica tre premi Gordon Bell.
Quando l'hardware è vincolato, l'ottimizzazione software diventa la leva principale delle prestazioni.
Fonti
2- 01量子位 (QbitAI) : PCIe 显卡被低估了 — DeepSeek 推理吞吐翻近 7 倍ZH
- 02量子位 (QbitAI) : page d'accueil de la rédactionZH
Tutti i numeri e le citazioni di questo testo provengono dalle fonti elencate sotto.
I contenuti sono stati preparati dalla redazione con il supporto dell'IA.
Giulia Ferrari
Commenti
0- Nessun commento — sii il primo.