推理引擎:METASTONE 让 DeepSeek V4.1 Flash 在 PCIe GPU 上吞吐提升 6.87 倍
八张没有高速互联的 PCIe 显卡,METASTONE 的 Meta-Infer 引擎把输入吞吐从每秒 1 932 个 token 提到 13 274 个。模型没动,改的是 kernel 和通信。
 林晓雯人工智能、模型与技术
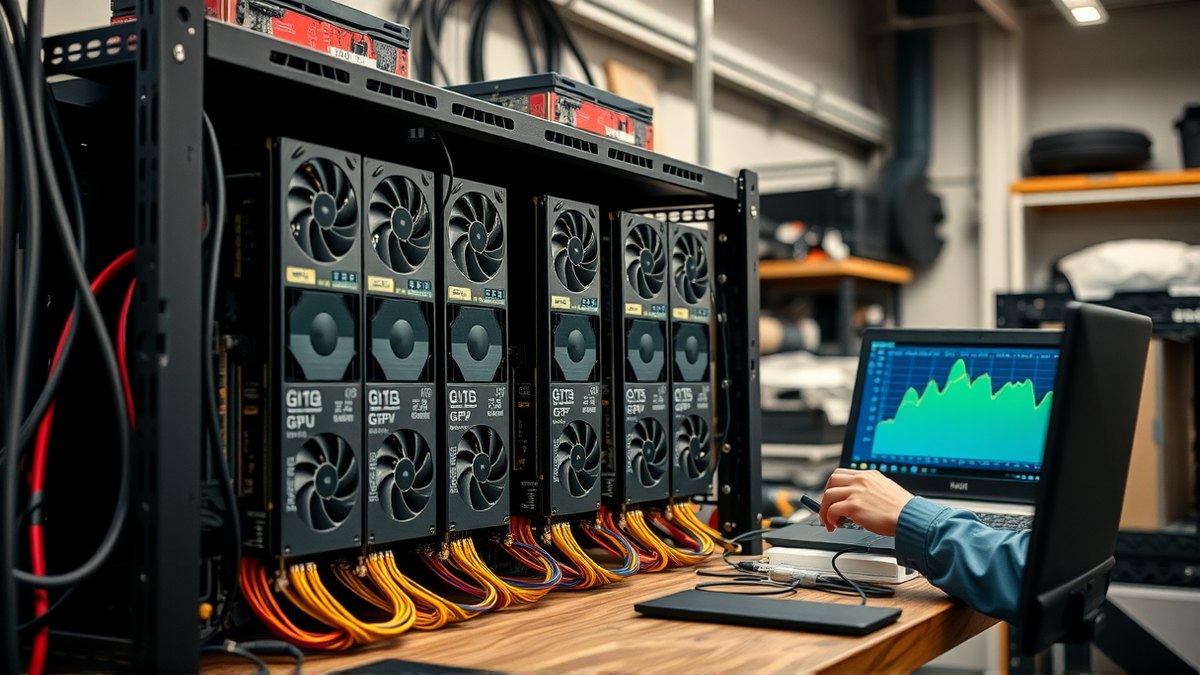
AI 芯片的讨论正在转向。问题不再只是谁能买到最强的硬件,而是谁能把手头已有的硬件用到位。中国公司 METASTONE 主张的正是这一点。据 量子位(QbitAI)报道,其推理引擎 Meta-Infer 就是为此而生。
框架与硬件之间的缺口
很多显卡都能加载模型、下载权重、起一个服务,也就是「能跑」。但在压力测试里,真实性能往往远低于宣传水平。模型本身没有缺陷,硬件也没有故障,损失来自框架与硬件之间的落差。这些卡彼此之间没有高速互联,也不在开源框架的官方验证矩阵里。结果就是一些算子悄悄退回效率很低的通用实现。通信参数仍按别的架构标定,显存和并行配置沿用为其他硬件准备的默认值。
吞吐提升 6.87 倍
Meta-Infer 只用软件解决这个问题,不改模型结构,也不改任务语义。做法分四块:补全 kernel,优化算子并重写通信,调整并行与显存容量,最后是缓存复用。
第一块修正那些阻碍原生优化算子执行的元数据和页大小,替换掉不合适的旧 kernel,放宽快速通信路径的阈值。在八张 PCIe 卡的环境里,用 DeepSeek-V4.1-Flash 的社区参考版本,输入吞吐只有每秒 1 932 个 token。这一阶段修正之后,升到每秒 5 850 个 token。
第二块针对瓶颈。在 PCIe 架构上,卡间带宽远低于专用互联,套用默认策略会让时间大量耗在通信等待上。通过算子融合、让计算覆盖通信、重写集合通信逻辑,引擎达到每秒 13 274 个 token,即 6.87 倍,并支持很长的上下文。
这套方法号称通用。换一个模型,输入吞吐从每秒 14 546 个 token 升到 22 584 个。仅做协同适配这一步,就有多个模型拿到 20% 到 33% 的吞吐提升。
一家第三方算力运营商
METASTONE 自称是端到端的独立算力运营商,不绑定任何模型供应商。公司表示管理超过 20 000 petaflops 的资源,运营十来个智能计算中心和两个国家超级计算中心,可用性承诺高于 99.95%。团队称拿过三次戈登·贝尔奖。
硬件受限时,软件优化就成了性能的主要杠杆。
资料来源
2- 01量子位 (QbitAI) : PCIe 显卡被低估了 — DeepSeek 推理吞吐翻近 7 倍ZH
- 02量子位 (QbitAI) : page d'accueil de la rédactionZH
本文所有数字与引语均来自下列来源,未添加来源之外的内容。
本内容由编辑部在人工智能辅助下制作完成。
林晓雯
评论
0- 还没有评论——来说两句吧。