Alibaba pokazuje Zhenwu V900 i otwiera kod stacku SAIL
Na konferencji Yunqi w Hangzhou Alibaba zaprezentowała chip Zhenwu V900, nazywany najmocniejszym chińskim akceleratorem AI. Dzień później T-Head udostępniła w open source komponenty stacku software'owego SAIL.
 Marta ZielińskaAI, modele i technologie
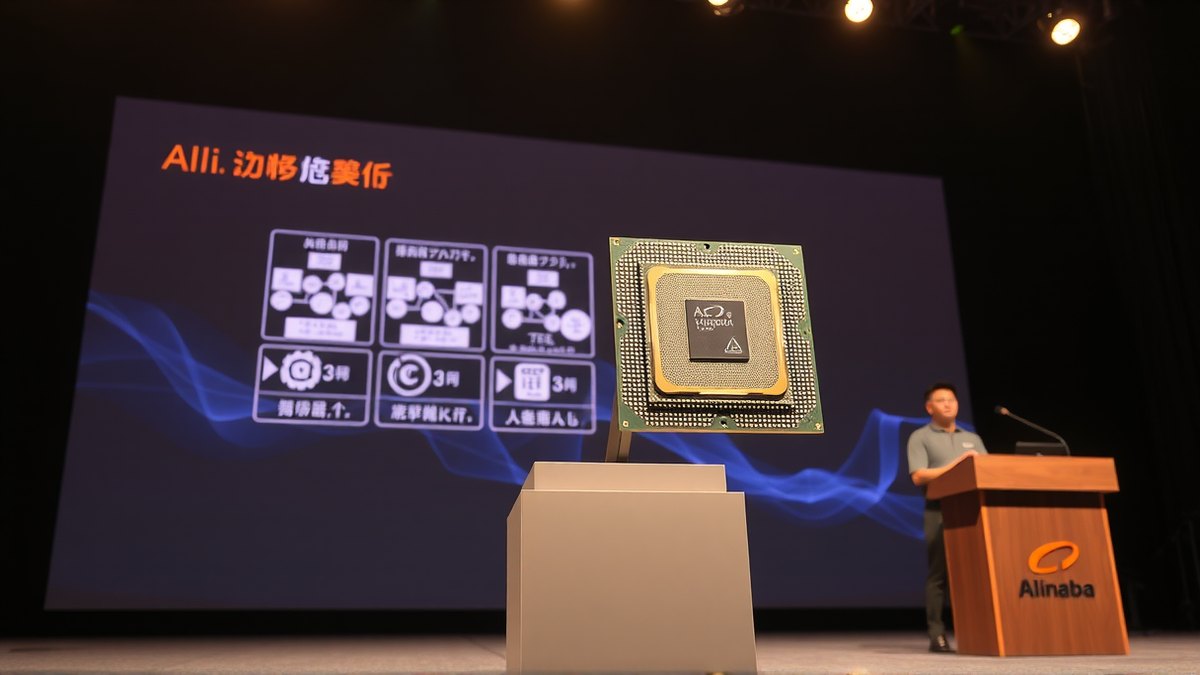
22 września na konferencji Yunqi w Hangzhou prezes Alibaby Wu Yongming przedstawił akcelerator 真武 V900. Firma opisuje go jako najmocniejszy chiński chip AI pod względem wydajności, z deklarowaną przewagą trzykrotności nad modelem M890 z poprzedniej generacji. Następnego dnia spółka zależna T-Head opublikowała postępy w otwieraniu towarzyszącego mu stacku software'owego.
Co zostało otwarte
Pakiet T-Head SAIL obejmuje adaptację frameworków obliczeniowych, biblioteki akceleracji, toolchain oraz biblioteki komunikacyjne. W publikacji znalazły się komponenty PyTorch-for-sail, sailify, Triton-for-sail, DeepGEMM-for-sail i FlashAttention-for-sail. PCCL i DeepEP-for-sail zapowiedziano jako nadchodzące. Otwarcie narzędzi, a nie tylko krzemu, ma konkretny cel: umożliwić wdrożenie chipa bez przepisywania istniejących modeli.
Firma informuje o ponad 650 klientach w ponad 20 branżach, w tym Ant, Xiaohongshu i XPeng. Xiaohongshu opracowało agentów do zarządzania migracją obciążeń i optymalizacją operatorów. W katalogu ModelScope dostępnych jest 39 modeli skwantyzowanych, m.in. Qwen, DeepSeek i Kimi, z ponad 348 000 pobrań we wrześniu 2026. Przewaga konkurencyjna zależy więc zarówno od społeczności deweloperów, jak i od wydajności.
Moc obliczeniowa pozostaje deficytowa
W tle jest problem podaży. Raport Inspur i IDC z AICC 2026 szacuje, że pokrycie globalnego popytu na moc obliczeniową dla AI spadnie z 79% w 2024 roku do 71% w 2027, by wzrosnąć do 77% w 2030. Lukę w wartościach bezwzględnych wyceniono na 380,9 mld dolarów w 2030 roku, co jest prawie dziesięciokrotnie więcej niż w 2024. Globalne zużycie tokenów ma rosnąć w tempie CAGR 4 822,6% do końca dekady, z około 4 000 bilionów operacji inferencji rocznie.
Na tej samej konferencji Inspur zaprezentował system 元脑 SD200 Ultra, zwiększając konfigurację z 64 do 128 chipów. Pamięć i przestrzeń dyskowa rozszerzają się do 8 i 64 terabajtów, a całość łączy z platformą HC2000. To obraz konkurencji przenoszącej się z pojedynczego procesora na system: kto integruje krzem, software i skalę dystrybucji, ten zmniejsza ryzyko wypadnięcia z rynku.
Źródła
2- 01量子位 — 阿里真武 V900 发布, T-Head SAIL 开源 (Yunqi Conference, Apsara 2026)ZH
- 02量子位 — 浪潮 AICC 2026 与 IDC 《2026 中国人工智能计算力发展评估报告》ZH
Wszystkie liczby i cytaty w tym tekście pochodzą z poniższych źródeł. Nie dopisujemy danych, których w źródłach nie ma.
Materiały zostały przygotowane przez zespół redakcyjny wspierane przez AI.
Marta Zielińska
Komentarze
0- Brak komentarzy — bądź pierwszy.