DAMO RADAR: Ein Modell erkennt 146 Erkrankungen in 18 Bauchorganen
Das chinesische Generalmodell für die medizinische Bildgebung wurde am 18. September 2026 in Science vorgestellt. Bei fast 40.000 Untersuchungen lag der mittlere AUC-Wert bei 0,913. Algorithmus und Gewichte sind öffentlich zugänglich.
 Hanna VogtWissenschaft und Gesundheit
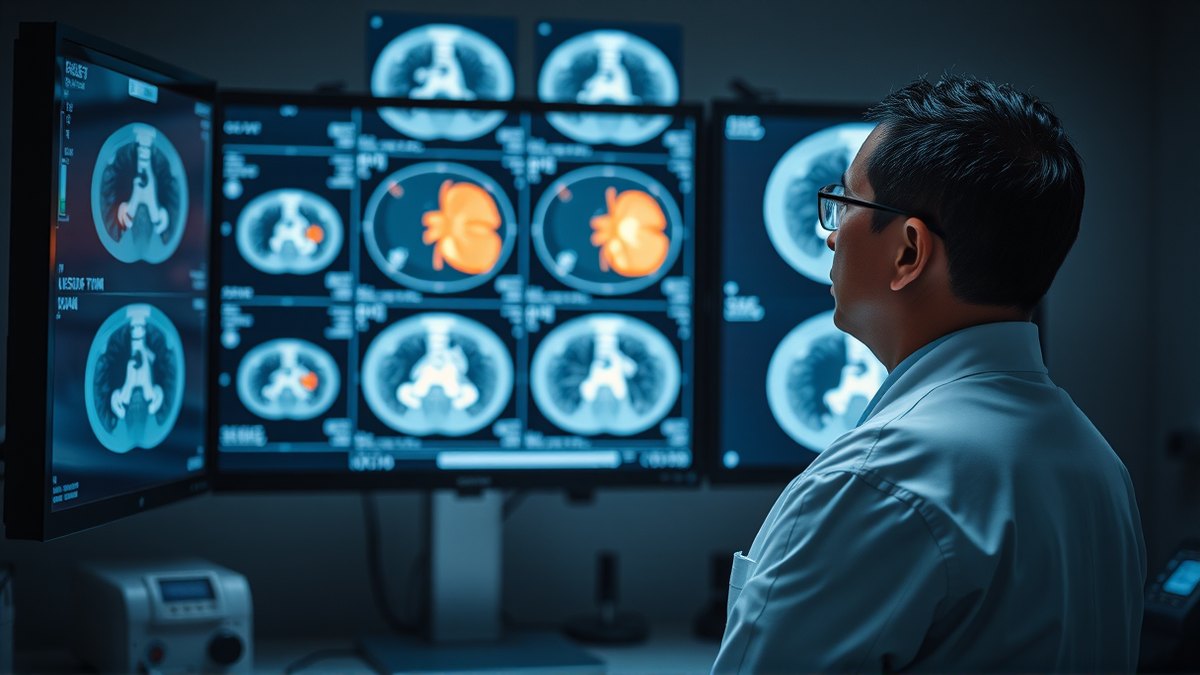
Die Alibaba DAMO Academy und das erste angegliederte Krankenhaus der Medizinischen Fakultät der Universität Zhejiang haben DAMO RADAR am 18. September 2026 in Science veröffentlicht. Es handelt sich um ein Generalmodell für die medizinische Bildgebung: Ein einzelnes System erkennt 146 Arten von Erkrankungen in 18 anatomischen Organen des Bauchraums. Grundlage ist eine kontrastmittelgestützte Computertomografie.
Bisher folgte die medizinische Bildgebung dem Prinzip „eine Krankheit, ein Modell“. Lungenknoten, Pankreaskarzinom oder diabetische Retinopathie hatten jeweils eigene Werkzeuge. Laut DAMO hängen solche Modelle weitgehend von manuellen Annotationen ab und sind teuer. Das Training für eine einzige Erkrankung dauert gewöhnlich zwei Jahre. Danach generalisieren sie nicht auf andere Krankheiten. Das Generalmodell soll diese Abhängigkeit verringern.
Für RADAR wählte man eine schwierige Aufgabe. Eine einzelne CT-Untersuchung enthält Hunderte Schnittbilder. Die Organe des Bauchraums überlagern sich und haben eine ähnliche Dichte. Das Signal von Veränderungen kann deshalb sehr subtil sein. Das Modell lernte Bild und Sprache zugleich: Bilddaten wurden mit Beschreibungen in diagnostischen Berichten verknüpft. Der Mechanismus erkennt zuerst das Organ, also die Leber, das Pankreas oder den Verdauungstrakt, und verbindet es erst dann mit der Beschreibung im Bericht. Dadurch wird es nicht vom Hintergrund gesunder Gewebe abgelenkt.
Wie es im Vergleich zu Ärzten abschnitt
Die Evaluation umfasste 18 Organe und 146 Erkrankungen. Bei fast 40.000 realen Untersuchungen lag der mittlere AUC-Wert bei 0,913. Dieser Wert misst die Fähigkeit, einen kranken von einem gesunden Menschen zu unterscheiden; 1,0 ist das ideale Ergebnis. Um das Modell mit Menschen zu vergleichen, luden die Teams 26 Radiologen aus 14 Zentren ein, 11 erfahrene und 15 mit kürzerer Berufserfahrung. Ärzte und Modell bewerteten CT-Untersuchungen von 300 Patienten. Im Mittel schnitt RADAR besser ab als 23 der 26 Ärzte. Nur drei erfahrene Radiologen erzielten etwas höhere Ergebnisse als das Modell.
Im Test der Zusammenarbeit von Mensch und Maschine erhöhten die Hinweise des Modells die Sensitivität bei der Erkennung von Erkrankungen um etwa 10 Prozent. Die mittlere Lesezeit eines Falls verkürzte sich um 30,7 Prozent. In einem Teil der Tests erreichten jüngere Radiologen mit KI-Hinweisen eine höhere Sensitivität als ältere Kollegen ohne Unterstützung.
DAMO vergleicht das Generalmodell mit einer Navigation. Es ersetzt den Arzt nicht bei der endgültigen Diagnose, sondern weist auf mögliche Erkrankungen und Bereiche hin, die leicht übersehen werden. „Der Kern eines dedizierten Modells ist hohe Präzision, der Kern eines Generalmodells ist breite Abdeckung“, argumentiert das Unternehmen. Beide Wege konkurrieren demnach nicht, sondern bewähren sich in verschiedenen klinischen Szenarien.
Der Code des Algorithmus und die Gewichte des Modells sind vollständig öffentlich zugänglich, für die Medizin und die Wissenschaft weltweit. Die Veröffentlichung allein ist jedoch nicht dasselbe wie die Einführung in die Praxis. Über den tatsächlichen Wert werden Tests in weiteren Krankenhäusern und in Populationen entscheiden, die sich von der Trainingspopulation unterscheiden.
Quellen
2Alle Zahlen und Zitate in diesem Text stammen aus den unten genannten Quellen.
Die Materialien wurden vom Redaktionsteam mit Unterstützung von KI erstellt.
Hanna Vogt
Kommentare
0- Noch keine Kommentare — seien Sie der Erste.