美国最高法院:纯AI生成作品无作者,争议未止
最高法院拒绝审理斯蒂芬·塞勒案,机器作者问题就此定论。但争议转移到了用他人数据训练模型的合法性上,欧盟的数据规则正在改变这一领域的游戏规则。
 孙一凡评论与观点
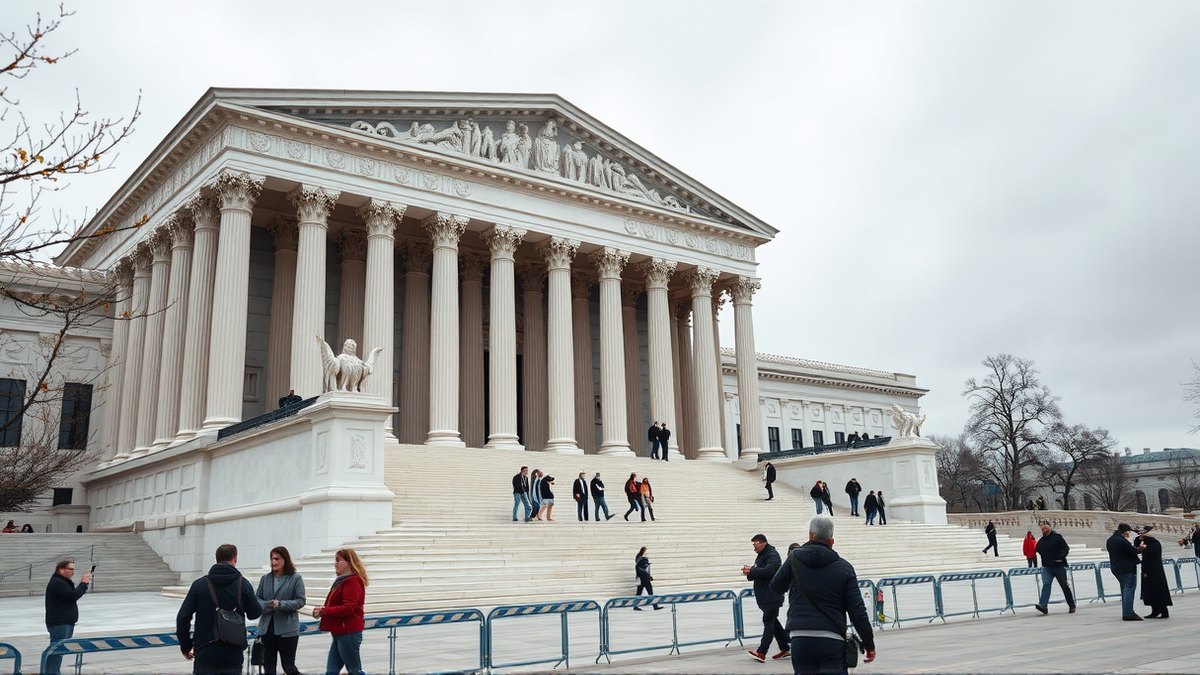
论点:纯AI生成作品不受保护,这一立场逻辑自洽,但并未解决市场价值问题。真正的争议向上游转移:在他人创作上训练模型是否合法。在此问题上,美国与中国的判决截然相反。
2026年3月2日,美国最高法院拒绝受理科学家斯蒂芬·塞勒的上诉。塞勒主张其AI系统生成的图像应受版权保护。他早在2018年就为作品《A Recent Entrance to Paradise》申请登记,此前已在版权局败诉。2022年,版权局裁定创作必须拥有“人类作者”。2023年,华盛顿联邦法官称人类作者身份是保护的“根本要求”。2025年,哥伦比亚特区巡回上诉法院维持了这一裁定。
该裁定结束了这一线索,但争论并未终结,原因有二。首先,版权局一贯拒绝登记Midjourney生成的图像,即便申请人主张“与AI共同创作”。界线清晰:无人参与,即无权利。其次,纯AI生成仅占市场边缘。价值产生于训练数据侧,而非生成结果侧。
华盛顿无法裁决的分歧在此显现。武汉一家法院认定,若AI内容创作者通过编写提示词、选择参数来控制并预见结果,即可享有版权。这是该市首例此类案件。这一理论与美国相反:关键不在于谁画出了像素,而在于谁掌控了过程。两大AI市场基于两种不同的作者定义,未来必须厘清这对跨境作品意味着什么。
欧盟在另一领域解决同一问题:数据保护法。Politico披露,爱尔兰主席国于2026年9月3日达成的妥协方案,恢复了将个人数据用于AI训练默认视为“合法利益”的设想。德国曾为此游说,理由是此举有助于欧洲企业。noyb的马克斯·施雷姆斯直言这是“对欧洲人的数字征用”,并称该方案是“将欧洲数据彻底向全球巨头敞开”。
三种模式并存。美国要求人类参与,决定权归于人类。被告公司也承认这一点,承认曾在受保护材料上训练。中国看重对过程的控制。欧洲不裁定作者身份,而是试图广泛开放输入数据。三种法律哲学共存于同一条全球价值链,构成了监管套利的配方。企业将在成本最低处训练,在价格最高处销售,前提是法院能跟上技术步伐。
资料来源
3- 01美国最高法院一锤定音,AI 作品不受版权保护ZH
- 02全国首例 AI 生成图著作权案在武汉判决ZH
- 03"Digitale Enteignung": Datenschützer warnen vor Pauschalerlaubnis für KI-TrainingDE
本文所有数字与引语均来自下列来源,未添加来源之外的内容。
本内容由编辑部在人工智能辅助下制作完成。
孙一凡
评论
0- 还没有评论——来说两句吧。